LLMO対策とは?SEOとの本質的な違いと実務で機能する4つの方法
「LLMO対策をすればAIに引用される」という理解は、半分正しく、半分は誤解です。実際にはAIオーバービューに引用されてもクリック数が6割近く減少したケースがあり、弊社の測定では可視性スコアが測定タイミングで最大5.9倍ぶれました。この記事では、LLMOの学術的な定義から実務での測定精度の限界、誤情報の検知やサイテーション管理まで、生成AI時代に実際に機能する方法を整理します。
LLMO対策とは何か?——定義と学術的な背景
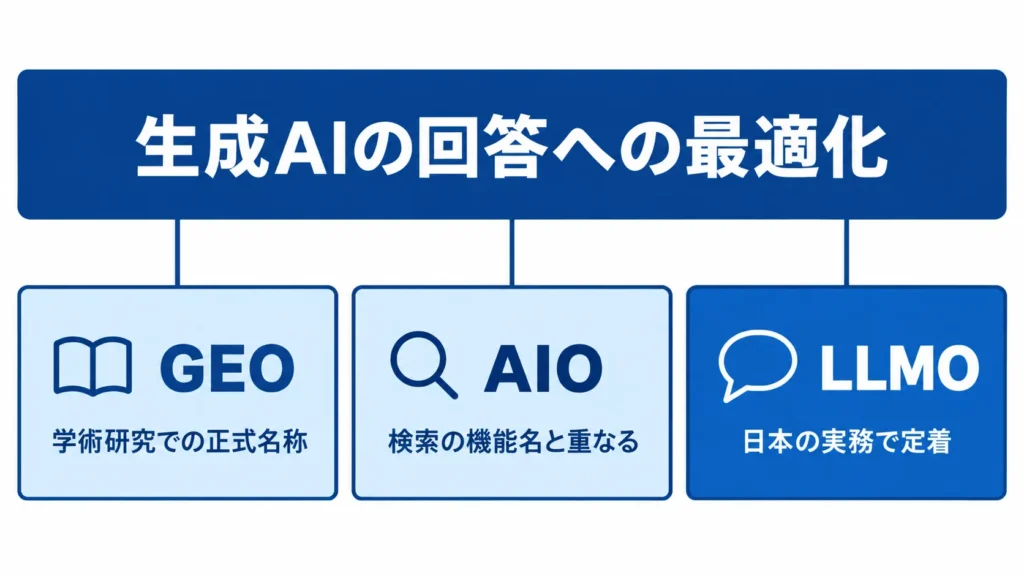
LLMO対策という言葉は、SEO業界で急速に広がりつつある一方で、その定義や背景を正確に理解している実務者は多くありません。「生成AIに自社情報を出す施策」という漠然とした理解のまま施策に入ると、測定の誤差や効果の見誤りが起きやすくなります。ここでは、学術的な定義であるGEO(生成エンジン最適化)の研究成果から押さえ、LLMO・AIO・GEOという呼称の違いと、大規模言語モデルが情報を参照する仕組みを整理します。これらの背景を理解しておかないと、後の施策判断で「何を優先すべきか」が見えづらくなります。
GEO(生成エンジン最適化)としての学術定義
LLMO対策の学術的な起点は、2023年11月にプリンストン大学らの研究チーム(Aggarwal et al.)が発表した「生成エンジン最適化(GEO:Generative Engine Optimization)」です。この研究はACM KDD 2024に正式採録され、Webサイトの記述構造をブラックボックス最適化することで、生成AI回答内での可視性を最大40%向上できることを制御実験で実証しました。
同研究のベンチマークであるGEO-benchでは、最良の手法群がPosition-Adjusted Word Countで41%、Subjective Impressionで28%の改善を示しています。一方で、従来SEOで多用されたキーワードの詰め込みは有効に機能しなかったという結果も示されており、SEOとは異なる最適化の軸が存在することが明らかになりました。つまり、生成AIに対しては「どう書くか」よりも「どう理解されるか」を設計する視点が重要だということです。
LLMO・AIO・GEOの呼称の違いと実務上の使い分け
日本ではLLMOのほかにAIO、GEOという呼び方が併存しています。学術的な起点はGEOで、英語圏でもGEOが通用します。私がLLMOと書くのは、日本の実務者がその語で検索し、その語で相談してくるからで、それ以上の理由はありません。呼び方の違いに実務上の差はなく、この記事ではLLMOで統一します。
大規模言語モデルが情報を参照する仕組み
AIが回答を組み立てるとき、学習済みの知識だけで答える場合と、その場でWebを検索して引用しながら答える場合があります。実務で問題になるのは後者で、引用元は公式サイトとは限りません。弊社の測定でも、企業名を含む質問に対してAIが古い第三者記事を引用し、公式サイトと異なる案内をした例を確認しています。特に、Chenら(2025)の大規模な比較分析は、AI検索エンジンがGoogle自然検索と比較して第三者による権威メディア(アーンドメディア)を系統的に偏重すると報告しており、公式サイトの情報だけでは不十分だという現実を示唆しています。つまり、自社サイトの整備に加え、外部からの評価や言及をどう設計するかが、LLMOの実務では重要になるということです。
LLMOとSEOの本質的な違い——最適化の対象と成果の指標
「SEOの延長でLLMOに取り組めばいい」という考え方には無理があります。両者はWeb上の情報を扱う点では地続きですが、何を相手にし、何を成果として見るかが違います。この違いを曖昧にしたまま進めると、順位は維持されているのに流入だけが減る、という損失に気づけません。ここでは実務の判断に必要な範囲で、その境界線を引いておきます。
「順位を上げる施策」と「理解される設計」の違い
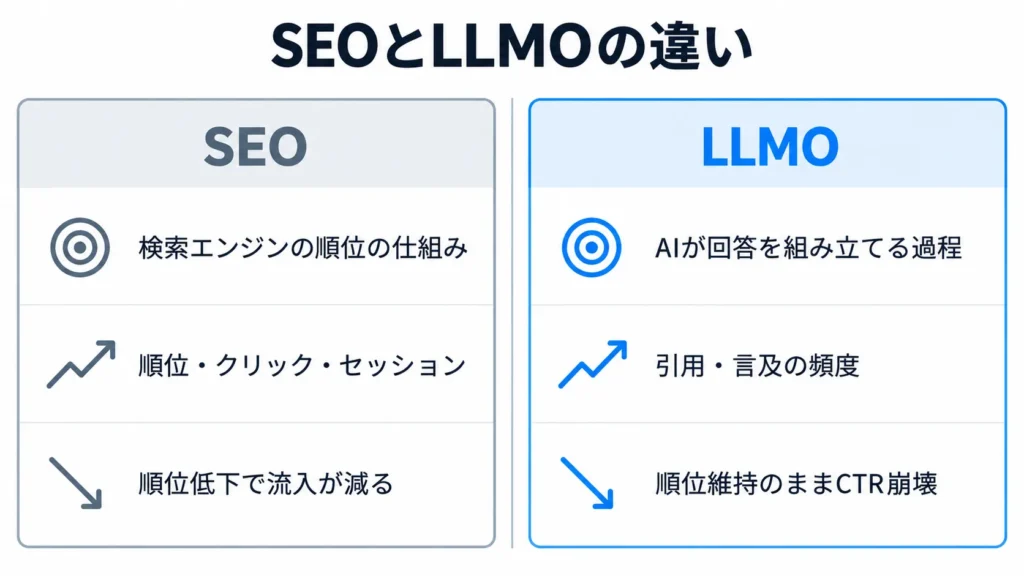
SEOで調整する相手は、Googleがページを評価し順位を決める仕組みです。構造化データ、内部リンク、被リンクといった要素は、その評価軸に対して手を打つものだと整理できます。一方でLLMOが相手にするのは順位の仕組みではなく、大規模言語モデルが情報を読み取り、回答を組み立てる過程そのものです。
この違いを裏づけるのが、プリンストン大学らのGEO研究(Aggarwal et al., 2023)です。Webページの記述構造を変えるだけで生成AI回答内の可視性が最大40%動いた一方、SEOで多用されたキーワードの詰め込みは効きませんでした。順位を競う軸とは別に、「どう読まれるか」を設計する軸が存在します。
順位が維持されていても損失が出る点に注意
SEOの成果はSearch Consoleやアナリティクスで、順位・クリック・セッションとして追えます。一方でLLMOの指標は「AIの回答に引用されたか」「どの頻度で言及されるか」という可視性であり、同じプロンプトを同じAIに投げても結果が揃いません。測れるものが変わった、という認識がまず出発点です。
とはいえ、より重要なのは指標が変わることで損失の見え方も変わる点です。自社とクライアントのサイトで測定を重ねる中で見えてきたのは、順位計測ツールが正常値を返し続けているのに、流入だけが崩れているクエリ群があるという状態でした。順位が落ちたわけではないので、従来のレポートには異常として現れません。この「順位維持のまま起きるCTR崩壊」が、LLMOで向き合う損失です。
「どちらを優先するか」ではなく「どのクエリを切り分けるか」
ここまで読むと、SEOとLLMOのどちらに軸足を置くべきかと考えたくなります。ただし実務で必要なのは二択ではなく、クエリの切り分けです。順位が落ちて流入が減ったクエリ群はSEOの領域、順位を保ったままCTRだけが崩れたクエリ群はLLMOの領域と整理すると、打ち手が混ざりません。
そのため、Search Consoleで「順位横ばい・CTR低下」のクエリを抽出する作業が、LLMOの実質的な入口になります。整った構造や事実性の高い記述はどちらの領域にも効きますが、それは両者が同じものだからではなく、同じ土壌を使っているからです。SEOの延長として同じ指標で追うのではなく、別の損失を別の指標で追う、という認識が現実的です。
LLMO対策の実務的な課題——測定精度と効果測定の限界
LLMO対策で最初につまずくのは、施策の中身ではなく「効いたかどうかをどう確かめるか」です。順位・クリック・セッションという使い慣れた物差しはAIの回答の中では機能せず、AIがどの情報源をどれだけ参照し、それがユーザー行動にどう影響したかを定量的に捉える手段は確立されていません。
自社でLLMO診断レポートを開発し、複数のサイトで測定を重ねた結果、測定タイミングによる誤差、引用とクリックの乖離、AIオーバービュー表示のばらつきという3つの壁が見えてきました。この壁を知らずに進めると、成果を誤認したまま次の判断に進むことになります。
| 課題 | 実測で確認したこと | 実務での対処 |
|---|---|---|
| 可視性スコアの測定誤差 | 同じプロンプト・同じAIで最大5.9倍のブレ | 3回分の移動平均を主指標にする |
| 引用とクリックの乖離 | 順位横ばい40件中82.5%にAIO表示、7割が自社引用。それでもクリックは6割近く減少 | Search ConsoleのCTR変動を補助指標に置く |
| 表示タイミングのばらつき | 同じ40クエリを2日空けて再取得したところ、AIO有無が5件入れ替わり | 1回の確認で判断せず、期間を空けて複数回測る |
いずれも1回の計測では見えない性質のもので、施策そのものより先に測定設計を組み直す必要があると考えると理解しやすいでしょう。
可視性スコアの測定誤差——最大5.9倍のブレと移動平均の必要性
LLMO対策の効果を測る指標として「可視性スコア」が使われることがあります。英語でいうと、「Visibility Score」とも言われます。これは、特定のプロンプトをAIに投げた際に、自社サイトがどの程度引用されるか、回答内でどの位置に表示されるかを数値化したものです。ただし、この数値は測定タイミングで大きくぶれます。
自社サイトと2社のクライアントサイトで、同じプロンプトを同じAIに投げる実験を繰り返したところ、測定タイミングで可視性スコアが最大5.9倍ぶれました。1回の計測で「AIに出ている/出ていない」を判断するのは無理があり、3回分の移動平均を主指標として採用する方針に切り替えています。この誤差は、AIの回答生成が確率的であること、リアルタイムでWeb情報を参照する際の検索結果の変動、モデルのアップデートなどが複合的に影響していると考えられます。
可視性スコアを単発で見て一喜一憂するのではなく、複数回の測定結果を平均化し、トレンドとして捉える姿勢が現実的です。
AIオーバービューの引用とクリック数の乖離——引用されても流入しない現実
AIオーバービューに自社サイトが引用されれば、従来のSEOと同様にクリック数が増えると期待するのは自然です。ただし、実態は異なります。
転職系メディアの実例で、Google順位が横ばいのクエリ40件を調べたところ、82.5%にAIオーバービューが表示され、そのうち7割は引用先に自社サイトが含まれていました。それでもクリック数は6割近く減少していました。「AIに引用されれば流入が戻る」という期待は成立せず、AIが答えを完結させてしまうため、引用されてもユーザーはサイトに訪れないという構造が明確に現れました。
この構造は、Search Consoleを月次で見ていても確認できます。順位は落ちていないのにCTRだけが崩れているクエリ群があり、順位計測ツールでは見えない損失が発生しています。これは「順位低下による損失」と「順位維持のまま起きるCTR崩壊」の二重構造であり、LLMO対策の対象は後者です。AIに引用されること自体は目的ではなく、AIが答えきらない領域で自社サイトの存在感を残すことが現実的な戦略です。
AIオーバービューの表示タイミングのばらつき——1回の確認では判断できない
AIオーバービューの表示タイミングも安定していません。同じクエリでも、検索するタイミング、地域、デバイス、ログイン状態などでAIオーバービューが出る/出ないが変わります。
同じ40クエリを2日空けて取り直したところ、AIオーバービューの有無が5件入れ替わりました。東京・デスクトップ・1回取得でこの結果です。AIオーバービューの有無を1回見て「このクエリはAIに対応されている/されていない」と判断するのは危険です。
さらに、AIオーバービューの引用リンクはリダイレクトのトークンで構成されており、そのままではどのページが引用されているかわかりません。引用リンクを追跡して初めて、「親サイト引用6件」だと思っていたものが全部下層ディレクトリの記事だったと判明するケースもありました。数える前に解決すべき手間があり、測定の精度を保つには相応のコストがかかります。
これらの課題を踏まえると、LLMO対策の効果測定は「長期的なトレンドで見る」「複数回の測定結果を平均化する」「Search ConsoleのCTR変動を補助指標にする」という組み合わせが現実的です。
実務で機能するLLMO対策の4つの方法
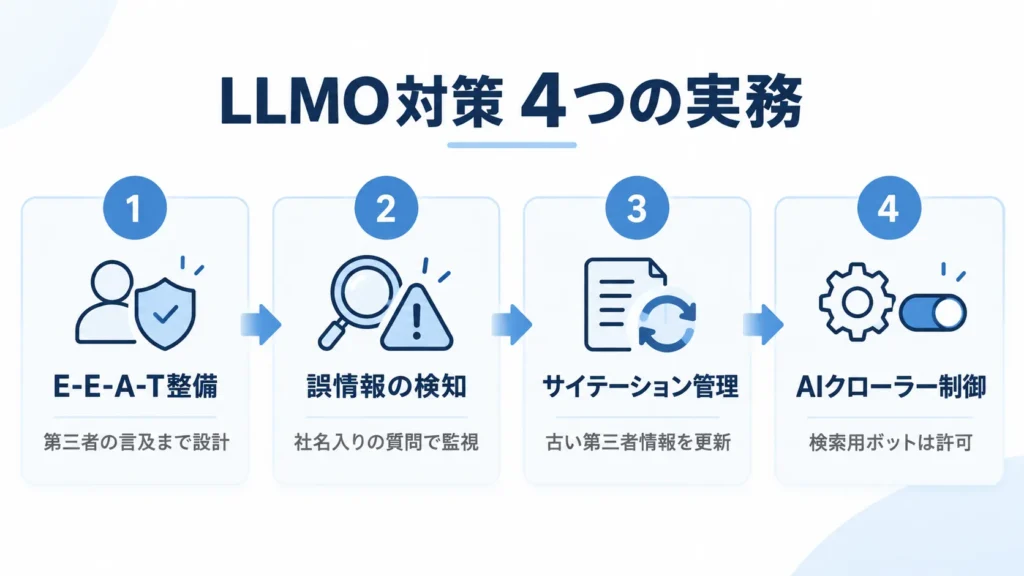
LLMOという言葉が広まる一方で、「何から手をつければいいのか」が曖昧なまま議論だけが先行している状況をよく見かけます。実務の現場では、測定精度の限界や誤情報の検知といった具体的な課題に直面するため、学術的な定義だけでは対処しきれません。ここでは、自社でLLMO診断レポートを開発する過程で確認した実例をもとに、実際に機能する4つの方法を整理します。
E-E-A-Tを自社サイト内で完結させない点に注意
前述のChenら(2025)の分析が示すとおり、AI検索は公式サイトより第三者の権威メディアを優先しやすい構造があります。この偏重を前提に考えると、この偏重を前提に考えると、自社サイト内でのE-E-A-Tの明示だけでは不十分で、第三者サイトでの言及内容まで視野に入れる必要があります。
実務では、著者プロフィール・監修者情報・実績・資格を明記することに加え、プレスリリースや業界メディアへの寄稿を通じて一次情報を外部に展開する動きが有効です。自社サイトに正確な情報があっても、AIはよそから拾うという前提で設計を組み立てると理解しやすいでしょう。
誤情報の検知と修正依頼——第三者サイトへのアプローチ
社名を入れたプロンプトは可視性を測る用途には向きませんが、誤情報の検出には使えます。医療系サービスのケースでは、Geminiが「往診できる」と誤案内していたことを検知し、8日後に解消を確認しました。誤情報の出どころは公式サイトではなく、古い第三者記事でした。公式に正しく書いてあっても、AIはよそから拾うという構造があるため、第三者サイトで間違った情報が掲載されている場合は、そのサイトにも新しい情報での掲載アプローチが必要です。
この対応は手間がかかる一方で、放置すると誤情報が継続的に拡散されるリスクがあります。優先順位としては、法的・医療的に誤解を招く内容を最優先とし、次にサービス内容の誤記、最後にブランドイメージに関わる表現の順で対処すると現実的です。
言及の「鮮度」を管理する役割——古い第三者情報の上書き
サイテーション(言及)は被リンクと異なり、自社名やサービス名がテキストで言及されているだけでも評価に影響します。ただし、古い情報のまま放置されている第三者サイトが多数存在すると、AIはそれらを参照して古い認識を維持してしまいます。
実務で厄介なのは、古い記述ほど長く残るという点です。数年前の料金体系やサービス名が第三者サイトに残っていると、公式サイトを更新しても、AIの回答には古いほうが出続けます。誤情報とまでは言えないため誰も指摘せず、気づくのは自社で社名プロンプトを投げたときだけ、というケースをよく見かけます。
だからこそ、引用の「量」ではなく「鮮度」を管理対象に据える発想が必要になります。定期的にサイテーションの内容を確認し、古い情報を掲載しているサイトには更新を依頼する。あるいは新しいプレスリリースを配信して上書きを促す。こうした継続的な管理が、結果的にAIの認識を最新の状態に保つ手段になると考えると理解しやすいでしょう。
サイテーションを確認したうえで、修正に応じないサイトが残る場合は、自社サイトと自社メディアの更新頻度を上げ、新しい情報で上書きされる状態を作ることが重要です。
AIクローラーの役割分離への対応——OAI-SearchBotの制御
OpenAIのAIクローラーは、事前学習用の「GPTBot」と検索インデックス用の「OAI-SearchBot」で役割が分離しています。OAI-SearchBotを拒否するとChatGPT検索の引用から除外されるため、両者の制御を区別して設定する必要があります。robots.txtで両方を一律に拒否すると、ChatGPTの検索機能で自社サイトが参照されなくなるリスクがあるということです。
実務では、公開情報はOAI-SearchBotを許可し、会員限定ページや未公開コンテンツはGPTBotとOAI-SearchBotの両方を拒否する、という段階的な制御が現実的です。クローラーの仕様は今後も変化する可能性があるため、定期的に公式ドキュメントを確認しながら設定を見直す姿勢が重要になります。
やらないこと・注意すべきポイント——LLMOの誤解と実務上のリスク
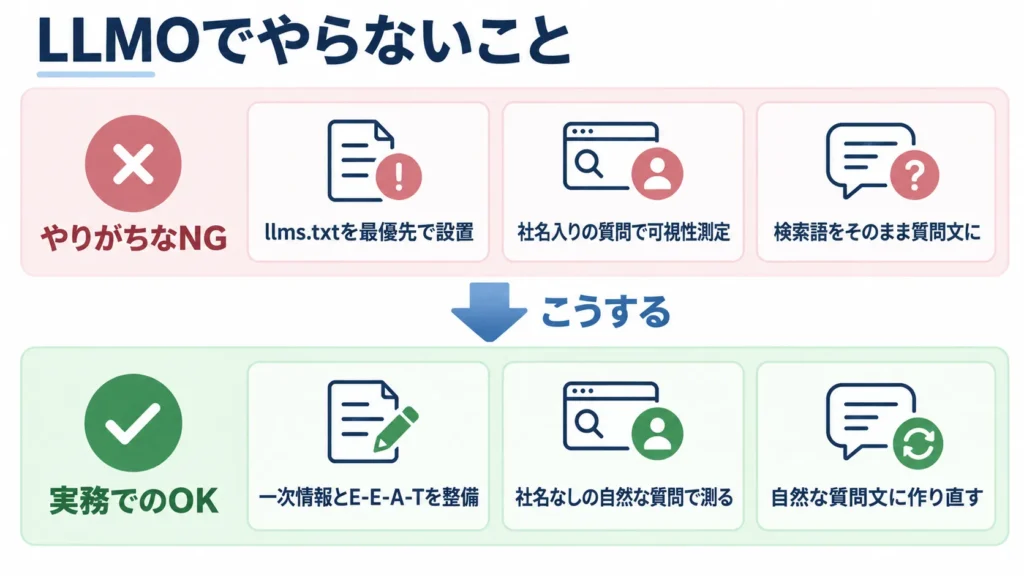
LLMO対策には「やれば効果が出る」という期待が先行しがちですが、実際には効果の測定基準が定まっておらず、施策によっては無駄な工数だけが積み上がるリスクがあります。実務の現場では、誤った情報や過大評価された手法に振り回されることも少なくありません。ここでは、やらないことを明確にし、限られたリソースを本質的な施策に集中させるための判断軸を整理します。
- llms.txtの設置を優先施策として扱わない
- 社名を含むプロンプトで可視性を測らない
- 検索語をそのままAIへの質問文に転用しない
いずれも工数の割に効果が見込めない、あるいは測定を誤らせる施策です。以下で、それぞれの根拠を実測データとともに整理します。
llms.txtは「設置すれば読まれる」ファイルではない点に注意
llms.txtは、2024年9月にAnswer.AIのJeremy Howard氏が提唱し、2026年8月10日にv2へ更新された仕様です。仕様そのものは更新が続いていますが、これを「AI検索対策の必須ファイル」と読むのは誤解です。Google Search Centralの公式ドキュメントは、Google検索(生成AI機能を含む)に表示されるためにllms.txtのようなAI向けファイルは不要であり、Google検索自体がそれを使っていないと明記しています。設置しても害はないが益もない、という位置づけです。
つまり、仕様が更新されていることと、検索側がそれを読むことは別の問題です。v2で追加されたのはコーディングエージェントや文書ツールがMarkdown版のページを見つけるための導線であって、AIオーバービューやAIモードでの露出とは関係がありません。リソースが限られている実務者であれば、この一枚のファイルに時間を割くより、E-E-A-Tの明示や一次情報の整備といった、人間とAIの両方に確実に届く施策に集中する方が現実的です。
社名を含むプロンプトでの可視性測定は無意味
「自社サービス名をAIに質問すると表示される」という確認は、可視性の測定としては機能しません。実際に自社でLLMOの診断レポートを開発し実験を重ねた結果、社名を含むプロンプトは「聞けば出るに決まっている」状態であり、可視性スコアの実測には向かないことが明確になりました。
一方で、この手法は誤情報の検出には有効です。医療系サービスで確認したように、公式サイトに正しく書いてあっても、AIが古い第三者記事を拾って別の案内をすることがあります。社名を含むプロンプトは、こうしたズレを見つけるための監視ツールとして機能します。だからこそ社名検索は「可視性の測定」ではなく「誤情報の監視」に位置づけるのが、実務上の正しい使い方です。
検索語をそのままAIへの質問文に転用する誤り
Search Consoleから取得した検索語をそのままAIへのプロンプトに転用しても、実態に合った測定はできません。初期段階で作成した42本のプロンプトセットは、実クエリから起こしたため検索語の言い回しのままでしたが、AIへの質問文とは語り方が根本的に異なります。
検索語は「llmo対策 やり方」のようなキーワードの羅列が中心ですが、AIへの質問は「LLMOの対策方法を教えてください」のような完結した文章です。この違いを無視してプロンプトを設計すると、AIが意図を正しく解釈できず、測定結果の信頼性が下がります。プロンプトは検索語の転記ではなく、ユーザーがAIに実際に投げかけそうな自然な質問文として再構成することが必要です。
FAQ
Q1. AIオーバービューに引用されているのに、クリックが減るのはなぜですか?
AIが回答を完結させるため、引用先として表示されても押されないからです。実例では、順位横ばいのクエリ40件のうち33件にAIオーバービューが表示され、その7割が自社サイトを引用していながら、クリックは6割近く減りました。引用は流入の保証にはなりません。
Q2. 可視性スコアが測定のたびに変わります。どう判断すればよいですか?
単発の数値で判断しないことです。弊社の測定では同じプロンプトでも測定タイミングで最大5.9倍ぶれ、条件次第ではさらに広がるため、3回分の移動平均を主指標にし、Search ConsoleのCTR変動を補助指標に置く運用が現実的です。効果の判断には数ヶ月単位の幅を見込んでください。
Q3. 自社名で聞けばAIに出てくるので、LLMO対策はできているのでは?
できていません。社名を含む質問は「聞けば出る」ため、可視性の測定には使えません。その手法は誤情報の検知に回し、可視性は社名を含まない自然な質問文で測る、という使い分けが必要です。社名プロンプトが役立つのは監視の場面です。AIは自社サイトだけでなく、他社サイトに残った古い情報も拾うからです。
Q4. llms.txtを設置していないと不利になりますか?
Google検索に関しては不利になりません。Google Search Centralの公式ドキュメントが、llms.txtはGoogle検索の生成AI機能に不要で、Google検索自体は使用していないと明記しています。設置しても害はありませんが、優先順位は低いと考える方が現実的です。
Q5. LLMO対策の費用はどこで決まりますか?
「診断だけか、継続観測まで含むか」で決まります。単発の診断と月額の定点観測では価格帯が変わりますが、LLMOは評価基準が定まっておらず、会社ごとに測るものが違います。金額より先に「何を、どう測るか」を確認してください。
まとめ
LLMO対策の本質は、「AIに引用されること」ではなく、「AIに正しく理解され、誤情報を生まない状態を維持すること」にあります。引用されても流入が戻るとは限らず、可視性スコアも1回の測定では判断できません。変動を前提に、移動平均で傾向を見る姿勢が必要です。
向いている人は、Search Consoleで「順位は維持されているのにCTRだけ崩れているクエリ群」を特定できる実務者です。一方で、短期的な数値改善を求める人や、llms.txtの設置だけで効果を期待する人には向いていません。Googleは同ファイルを検索の生成AI機能で使用しないと公式に明言しています。
まず取り組むべきは、社名を含むプロンプトで誤情報が出ていないかを確認することです。この設計段階で誤情報を検知し、第三者サイトへの修正依頼という判断を経て、サイテーション管理の実装へと進む流れが現実的です。可視性の向上を狙う前に、誤情報の不存在を確認する——この順番を崩さないことが、LLMO対策の実務における最初の一歩となります。
出典
本記事で参照した公的機関・一次情報は以下のとおりです。
この記事を書いた人

関連記事
-
 Googleトレンドの使い方と実務活用法|相対値の正しい読み方とSEO・マーケ戦略への応用
-
AIで「てにをは」を正確にチェックする方法|2026年の実用精度と使い分け
-
「てにをは」とは?その意味と具体的な使い方について紹介
-
ピクトグラムとは?歴史・AI時代の活用法とアクセシビリティ設計
-
Google AIモード(AI Overviews)完全ガイド|使い方・仕組み・無効化設定まで実務解説
-
Google画像検索のやり方と使い分け — 実務で失敗しない注意点とおすすめサイト6選
-
リッチリザルトとは?種類と仕組み、SEOでの活用と注意点をわかりやすく解説
-
Schema & Structured Data for WP & AMPとは?WordPressで構造化データを「管理」する
コメント